依据 Google 官方文档,2026 年 10 月核对

Google AI Studio做有声书:Gemini TTS 能帮你走多远

注册送免费积分,无需绑卡。

Gemini TTS 音质很好,AI Studio 也能免费试用。下面讲清怎么在里面配完一章、Google 文档写明的限制,以及做整本书还差哪些工作。

步骤一览共 4 步
  1. 1第 1 步打开语音生成
  2. 2第 2 步选说话人和声音
  3. 3第 3 步贴一段,加风格指令
  4. 4第 4 步生成、下载、重复
Alice's Adventures in Wonderland — The Cheshire Cat
旁白NaomiAliceAbbyCheshire CatSnik 使用方法
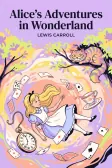
《Alice's Adventures in Wonderland》封面

Lewis Carroll

Alice's Adventures in Wonderland

爱丽丝向咧嘴笑的柴郡猫问路——结果什么也没问到。

The Cat only grinned when it saw Alice. It looked good-natured, she thought; still it had very long claws and a great many teeth, so she felt it ought to be treated with respect.

Cheshire Puss, would you tell me, please, which way I ought to go from here?

Cheshire CatSnik狡黠

That depends a good deal on where you want to get to.

I don't much care where—

Cheshire CatSnik狡黠

Then it doesn't matter which way you go.

—so long as I get somewhere.

Cheshire CatSnik狡黠

Oh, you're sure to do that, if you only walk long enough.

约 1 分钟 · 3 个声音 · 可以播放7
免费试听,无需注册。处理你自己的章节和导出需要一个免费账号。我准备好了 →
可选 AI 音色
137
70 个标准 · 67 个高级
可导入的文件格式
5
EPUB · PDF · DOCX · TXT · MD
导出方式
3
带章节的 M4B · MP3 · ZIP
语音模型
4
Gemini · ElevenLabs

分步指南

在 Google AI Studio 里配完一章:分步操作

用 Google AI Studio做有声书的手动路线,每一章都要重复一遍。

  1. 打开语音生成

    登录 Google AI Studio(Gemini API 要求年满 18 岁),打开语音生成,选一个 TTS 模型。Google 目前列出的是 3.8 Flash TTS 和 3.8 Flash-Lite TTS。
  2. 选说话人和声音

    旁白选单人模式,对话选多人模式(最多两人),从 30 个预置声音里给每人挑一个。
  3. 贴一段,加风格指令

    贴入一个场景或一小段,长度控制在一次请求的上限内,再加一句风格指令,比如“温暖、不急不慢的讲故事口吻”。
  4. 生成、下载、重复

    生成、试听、下载音频片段。每章的每一段都重复一遍,最后在音频软件里拼起来。

来自 Google 文档

做整本书会碰到的限制

用 Google AI Studio做有声书会遇到的问题,每条都出自 Google 自己的页面,2026 年 10 月核对。

  • 每次请求最多两个说话人

    Google 文档写明,单次请求的多说话人生成最多支持两人。角色再多,就得一轮一轮单独生成再拼接。
  • 每次输入 8,192 token

    模型页写明输入上限 8,192 token、输出上限 16,384 token,一章小说通常要拆成好几次请求。
  • 免费额度不公开

    TTS 模型在免费档不收费,但 Google 的速率限制页面只说额度要在 AI Studio 里查看。社区反馈部分模型低到每天 10 次。
  • 免费档数据会被使用

    免费档的输入和输出会被 Google 用来改进产品,也可能有人工审阅。付费使用不在此列。
  • 一段音频,不是一本书

    每次请求返回一段音频(API 返回 24 kHz 单声道 WAV)。没有章节列表、没有说话人识别,也没有 M4B。
  • 2027 年付费价格翻倍

    Google 定价页显示,3.8 系列 TTS 模型的付费价格从 2027 年 1 月 1 日起翻倍。规划大项目时要算进去。

并排对比

手动用 AI Studio,还是用多角色工作流

用 Google AI Studio做有声书和用 FullCastBook,声音同属一个家族,工作量却差很多。

FullCastBookGoogle AI Studio(Gemini TTS)
Gemini TTS 声音有,作为标准声音支持
免费起步注册送免费积分免费档,每日额度在 AI Studio 查看
每个场景的说话人数所有角色,逐句生成每次请求最多 2 人
识别每句台词的说话人支持不支持
导入 EPUB、DOCX 或 PDF支持仅文本输入
章节与 M4B 导出支持不支持
声音设计与声音复刻不支持支持
音频归属归你,以服务条款为准Google 不主张所有权

Google 相关信息来自其语音生成指南、模型页、定价、速率限制、API 条款和可用地区页面;ACX 规则来自其音频提交要求页面,均于 2026 年 10 月 21 日核对。AI Studio 的菜单经常变动,限制以 Google 文档为准。

来源: Gemini API:语音生成(2026-10-12 更新) · Gemini API:Gemini 3.8 Flash TTS 模型页 · Gemini API:定价(2026-10-19 更新) · Gemini API:速率限制(2026-10-15 更新) · Gemini API:附加服务条款 · Gemini API:可用地区 · ACX:音频提交要求(2026-04-15)

本页目录
  1. 1用 Google AI Studio做有声书,能做到什么程度
  2. 2Google AI Studio 的语音生成能做什么
  3. 3分步操作:在 AI Studio 里配完一章
  4. 4限制:两个说话人、输入长度、每日额度
  5. 5拼接章节,处理两个以上的角色
  6. 6发布:为什么 YouTube 教程里的 ACX 路线违反规则
  7. 7同样的 Gemini 声音,加上自动选角和 M4B 导出
  8. 8来源与日期

完整指南

用 Google AI Studio做有声书,能做到什么程度

用 Google AI Studio做有声书,本质上是自己动手:把文字贴进 Google 的语音生成页面,由 Gemini TTS 的声音朗读,再下载音频片段。这些声音属于目前最好的一批,免费档不花钱,做一个短篇或一章样章,可能就够了。

要做整本书,麻烦都藏在缝隙里:Gemini TTS 每次请求最多两个说话人,一次只能输入约 8k token,也完全不懂章节。这篇指南按 Google 官方文档(截至 2026 年 10 月)讲清操作步骤和限制、大家怎么绕过去拼接,以及一个热门教程在发布环节犯的错误。

Google AI Studio 的语音生成能做什么

Google AI Studio 是 Gemini API 的网页试验场,它的语音模式是体验 Google AI Studio 文字转语音最快的方式,Google 文档也建议先在这里测试再开发。文档列出四个 TTS 模型:Gemini 3.8 Flash TTS 和 3.8 Flash-Lite TTS(2026 年 9 月更新),以及 3.1 Flash TTS Preview 和 2.5 Pro Preview TTS。3.8 Flash 支持 130 多种语言,并会自动识别文字的语言。

演绎用自然语言来指挥:给某一轮加一句“cheerful and friendly”这样的风格指令;Google 还提供用尖括号写的行内声音事件,比如 <laugh>、<sigh>、<whispering>。共有 30 个预置声音,外加一个扩展声音库;AI Studio 还提供声音设计和声音复刻,这是专做有声书的工具未必有的。

分步操作:在 AI Studio 里配完一章

先拆章节。每次请求输入上限 8,192 token、输出上限 16,384 token,所以要在场景切换处把一章切成一次请求放得下的小段;如果音频提前断掉,就把这一段再切短。然后每一段:旁白选单人模式,选好声音,写一句旁白的风格指令,贴入文字,运行,下载音频。

给每一段记下模型、声音和风格指令。每次生成的结果都会有差异,同一个旁白在第一场听着温暖,到第三场可能就变得利落,除非所有设置都一样。每段都先听完再往下做:拼好的整本书,改起来比单个片段难得多。

限制:两个说话人、输入长度、每日额度

Gemini 多说话人 TTS 是大多数小说卡住的地方,Google 文档写得很清楚:单次请求的多说话人生成“最多支持 2 个使用预置声音的说话人”。角色更多,就要把每个说话人的台词单独合成。一个场景里有旁白加三个角色,就已经是四个声音,所以多数小说最后都得逐轮生成。

每日额度更难说清。TTS 模型在免费档不收费,但 Google 的速率限制页面现在只说额度可在 AI Studio 中查看,2026 年的社区反馈显示部分 TTS 模型的免费额度低到每天 10 次请求。免费档的输入和输出会用于改进 Google 的产品;3.8 系列的付费价格将在 2027 年 1 月 1 日翻倍。另外,Google 公布的 Gemini API 和 AI Studio 可用地区列表里没有中国大陆和香港。

拼接章节,处理两个以上的角色

手工做多角色,要把一章逐句过一遍:确定每句是谁说的,用这个人的声音生成他的台词,再在音频软件里按顺序拼起来。Google 提到,每个 WAV 响应都带 44 字节的文件头,用代码拼接前要去掉。最后加章节标记、统一响度、导出。

这些杂活——谁在说话、用哪个声音、什么顺序、章节从哪开始——正是多声音文字转语音工具要替你做的。一部有几十个说话角色的小说,片段会有成百上千个。如果你也在考虑聊天AI,ChatGPT能做有声书吗讲了它们会怎么处理书稿。

发布:为什么 YouTube 教程里的 ACX 路线违反规则

这个搜索词排名靠前的视频《Google AI Studio: Create an AI Audiobook and Publish It on Audible!》(2025 年 7 月)把 AI Studio 的操作讲得挺清楚,但最后一步教大家通过 ACX 上架。这一步站不住。ACX 日期为 2026 年 4 月 15 日的音频提交要求写明,有声书“必须由真人朗读,除非另获授权”,并且“未经授权在 ACX 作品中使用文字转语音、AI 或自动录音是被禁止的”。

Audible 在同一页面也说,正在努力接受第三方 TTS 内容,时间会另行公布,所以规则可能会变。在那之前,用 Gemini 朗读的书传到 ACX,可能被拒或被下架。当前规则见Audible 是否接受 AI 有声书;接受数字声音朗读(需勾选披露)的路线,见如何在 Spotify 发布有声书。

同样的 Gemini 声音,加上自动选角和 M4B 导出

如果你想要一本用 Gemini TTS 朗读的有声书,又不想管理成堆的片段:FullCastBook 的标准声音就运行在 Google 的 Gemini TTS 上,和你在 AI Studio 里听到的是同一个声音家族。区别在于周边的工作:上传 EPUB、DOCX、带文字层的 PDF、TXT 或 Markdown,章节和说话人自动识别。每一句都用它的说话人的声音单独生成,两人上限根本碰不到;[dry, unimpressed](冷淡、不以为然)这样的提示会作为这一句的风格指令一起发送。

你可以在浏览器里试听、单句重新生成,导出带章节标记的 M4B、整本 MP3 或每章一个文件的 ZIP。想换一种音色,还有 ElevenLabs 高级声音可选。注册送的免费积分够试一个短章节,整本需要多少见价格。

来源与日期

2026 年 10 月 21 日核对:Google 语音生成指南(2026 年 10 月 12 日更新)、Gemini 3.8 Flash TTS 模型页、Gemini API 定价页(2026 年 10 月 19 日更新)、速率限制(2026 年 10 月 15 日更新)、API 条款与可用地区(均为 2026 年 4 月 28 日更新),以及 ACX 音频提交要求(2026 年 4 月 15 日)。链接在对比表下方。Google 更新这些模型很频繁,开始任何长度的 Google AI Studio做有声书项目之前,请再核对一次限制。
常见问题

Google AI Studio做有声书:常见问题

没找到答案?发邮件到 support@fullcastbook.com

用 Google AI Studio 做有声书免费吗?

做短内容可以免费。Gemini TTS 模型在免费档不收费,但有每日额度(在 AI Studio 中查看),免费档数据会用于改进 Google 的产品,而整本书需要你自己拆分、拼接大量片段。

Gemini TTS 一次能配几个说话人?

按 Google 截至 2026 年 10 月的文档,每次请求两个。角色更多时,要单独生成每个说话人的台词再拼接,或者用逐句配音的工具,比如多声音文字转语音。

用 Google AI Studio 做的有声书可以卖吗?

Google 的 Gemini API 条款写明不主张生成内容的所有权,并说明 API 面向专业或商业用途。你仍然需要拥有文本的权利,各平台对 AI 朗读也有自己的规定。

Gemini 朗读的有声书能上传到 Audible 吗?

截至 2026 年 10 月,不能通过 ACX:它要求真人朗读,除非 Audible 另行授权。Audible 表示正在努力接受第三方 TTS,详见Audible 的现行规定。

做有声书用哪个 Gemini TTS 模型最好?

Google 目前列出的是 Gemini 3.8 Flash TTS 和 3.8 Flash-Lite TTS;Flash 支持的语言更多(130 多种对 100 多种)。用同一页对白两个都试一下,凭耳朵选。FullCastBook 的标准声音也用 Gemini TTS。

保留 Gemini 的声音,省掉拼片段的活。

上传一章,每句台词自动分配说话人、配音、拼好,可导出 M4B 或 MP3。注册送免费积分,无需绑卡。